الحالة ونقاط الحفظ في لانغ غراف: كيف يتذكّر وكيلك محادثتك بعد إغلاق البرنامج
الذاكرة في لانغ غراف ليست صندوقاً سحرياً بل ثلاث قطع منفصلة: الحالة (State)، ومُحافِظ النقاط (checkpointer)، والمخزن (store). يشرح المقال كيف تُدمج حقول الحالة بدوال الدمج، ولماذا إرجاع قائمة فارغة لا يفرّغ حقلاً مدموجاً، ولماذا يُعدّ thread_id المؤشر الدائم للمحادثة وحدّه الأقصى 255 حرفاً. كما يوضح الفرق بين الذاكرة الدلالية والبحث الدلالي، وينبّه إلى أن القنوات الخاصة في الحالة لا تُخفى أثناء البثّ.
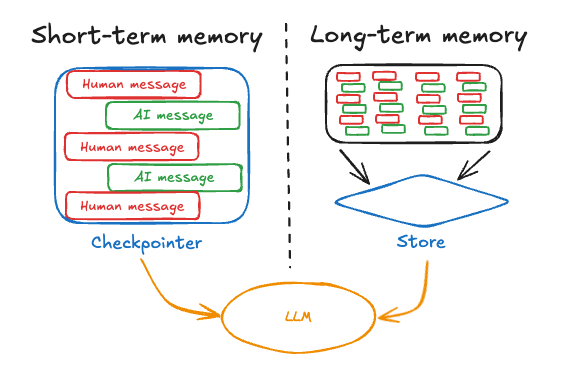
سؤال واحد يلاحق كل وكيل تبنيه: كيف يتذكّر محادثتك بعد أن تُغلق البرنامج؟ الجواب في لانغ غراف (LangGraph) ليس «صندوق ذاكرة» واحد، بل ثلاث قطع منفصلة: الحالة (State) التي تحمل بياناتك أثناء التنفيذ، ومُحافِظ النقاط (checkpointer) الذي يكتبها خارج العملية، والمخزن (store) الذي يحفظ ما يتجاوز حدود المحادثة. من يخلط هذه الثلاث يضيّع أسابيع في أخطاء لا تُظهر رسالة خطأ واضحة.
المصطلحات الأساسية في سطور
- الحالة (State) — لقطة مشتركة من بيانات تطبيقك؛ كل عقدة في الرسم تقرأ منها وتكتب فيها.
- دالة الدمج (reducer) — دالة تقرّر كيف يُدمَج ما تعيده عقدة مع القيمة القديمة في الحقل نفسه.
- نقطة الحفظ (checkpoint) — صورة للحالة تُكتب عند حدود الخطوات الكبرى (super-step).
- مُحافِظ النقاط (checkpointer) — الكائن الذي يكتب نقاط الحفظ؛ يوفّر ذاكرة قصيرة المدى محصورة في محادثة (thread) واحدة.
- المخزن (store) — مخزن بيانات يحدّده التطبيق خارج الحالة؛ يوفّر ذاكرة طويلة المدى مشتركة بين المحادثات.
thread_id— معرّف المحادثة؛ المؤشر الدائم الذي تعيد استخدامه لاستئناف الجلسة.- الذاكرة الدلالية والتجريبية والإجرائية — ثلاثة أنواع للذاكرة طويلة المدى، نفصلها في آخر المقال.
⚠️ اقرأ هذا التحذير قبل المثال الأول: كل درس وكل tutorial تقريباً يبدأ بـ
InMemorySaver. الوثائق تنصّ حرفياً على أنMemorySaverوInMemorySaverيخزّنان نقاط الحفظ في الذاكرة العشوائية (RAM)، وأن كل النقاط تضيع عند إعادة تشغيل العملية. استخدمه للتجربة داخل جهازك فقط، ولا تدخل به الإنتاج قبل أن تستبدله بمحفّظ يكتب على القرص.
📌 توضيح الاسم قبل أن نبدأ: كلمة «لانغ تشين» في الأدبيات تستعمل لثلاثة أشياء مختلفة — حزمة
langchainوهي إطار الوكلاء، ولانغ سميث (LangSmith) وهو منتج تجاري مستضاف للتتبّع والتقييم، وشركة LangChain Inc. المقصود في هذه المقالة هو لانغ غراف، بيئة التشغيل التي تنفّذ فوقها الحزمة الأولى. ولهذا السبب يفيدك أن تُحدّد أيّ طبقة يقصدها الكاتب قبل أن تثق بمثال.
ما الفرق بين الحالة ومُحافِظ النقاط (checkpointer) والمخزن (store)؟
الوثائق الرسمية تضع الحدّ في جملة واحدة: طبقة الاستمرارية في لانغ غراف تمنح الوكلاء ذاكرة قصيرة المدى عبر مُحافِظات النقاط وذاكرة طويلة المدى عبر المخازن. أي أن «الذاكرة» ليست خاصية واحدة، بل التقاء ثلاث آليات.
| القطعة | ماذا تحفظ | نطاقها | ما الذي توفّره فعلياً |
|---|---|---|---|
State |
بيانات التطبيق أثناء التنفيذ | جولة التنفيذ الحالية | في الذاكرة ما لم يوجد مُحافِظ نقاط |
checkpointer |
نقاط حفظ الحالة | محادثة واحدة معرَّفة بـ thread_id |
ذاكرة قصيرة المدى: استمرارية المحادثة، التدخّل البشري، السفر عبر الزمن (time travel)، تحمّل الأعطال |
store |
بيانات يحدّدها التطبيق خارج الحالة | عبر المحادثات | ذاكرة طويلة المدى: تفضيلات المستخدم، الحقائق، المعرفة المشتركة |
الخلاصة العملية: لو بنيت رسماً بلا checkpointer فسيبدأ الوكيل من جديد في كل طلب. ولو أضفت checkpointer بلا store فسيتذكّر داخل المحادثة الواحدة وينسى المستخدم عند فتح محادثة ثانية. والخلط الثالث الذي يقع فيه كثيرون هو أن يعتقدوا أن استدعاءً واحداً لـ create_agent «جهّز الذاكرة» — وهو غير صحيح: لا شيء يُحفظ إلا ما مرّ عبر checkpointer أو store.
كيف تُكتب حالة الوكيل في لانغ غراف؟ بـ TypedDict ودوال الدمج
الحالة في لانغ غراف هي «بنية بيانات مشتركة تمثّل اللقطة الحالية من تطبيقك»، وقد شرحنا في المقال السابق كيف يبني create_agent حالته الجاهزة. الطريقة الموصى بها لتعريفها بنفسك هي TypedDict مع typing.Annotated.
TypedDict ليس مجرّد اختصار: هو الطريق الموصى به لأنه لا يفرض طبقة تحقق (validation) على كل خطوة في الحلقة. عند استخدام Pydantic تتولّد كائنات وتُفحص القيود في كل قراءة وكتابة، وهذا فرق أداء محسوس في حلقة وكيل متكرّرة. والأهم أن create_agent نفسه لا يقبل مُخطَّطات حالة من نوع Pydantic — الوثائق تقولها صراحة: مصنع create_agent الأعلى مستوى في langchain لا يدعم مُخطَّطات حالة بـ Pydantic. فإذا كنت تستخدم create_agent فالخيار ليس «الأبطأ» فحسب، بل المسار غير المدعوم.
pip install -U langgraph
import operator
from typing import Annotated, TypedDict

from langgraph.graph import START, StateGraph


class State(TypedDict):
    notes: Annotated[list[str], operator.add]  # حقل مدموج: تُضاف إليه القيم
    status: str                                # بلا دالة دمج: يُكتب فوقه


def collect(state: State) -> State:
    return {"notes": ["note-a"], "status": "running"}


def review(state: State) -> State:
    return {"notes": ["note-b"], "status": "reviewed"}


builder = StateGraph(State)
builder.add_node("collect", collect)
builder.add_node("review", review)
builder.add_edge(START, "collect")
builder.add_edge("collect", "review")

graph = builder.compile()  # التجميع إلزامي قبل الاستخدام

print(graph.invoke({"notes": [], "status": "new"}))
# {'notes': ['note-a', 'note-b'], 'status': 'reviewed'}
المخرج وحده يشرح القاعدة: notes اجتمع فيه ما أعادته العقدتان لأن له دالة دمج، بينما status لم يبقَ فيه إلا قيمة review الأخيرة لأنه لا دالة دمج له.
ما الفرق بين دالة الدمج الافتراضية ودالة دمج مخصّصة؟
القاعدة التي تربك الكثيرين: الحقل الذي لا تحمل Annotated فيه دالة دمج، يُكتب فوقه. الوثائق تصف الافتراضي بدقة: الدالة الافتراضية تتجاهل الطرف الأيسر وتستبدل قيمة الحالة بالطرف الأيمن.
أمامك ثلاث حالات عملية:
operator.add— دمج قائمتين أو جمع عددي، يناسب الحقول التي تنمو: ملاحظات، مصادر، سجلّ أحداث.add_messages— يتتبّع المعرّفات: إذا كانت رسالة واردة تحمل نفسidالموجود في القائمة القديمة، فإن الجديدة تحلّ محلّ القديمة بدل أن تُضاف إليها. هذا ما يجعل حقل الرسائل append-only عملياً: لا تتراكم نسخ مكرّرة من الرسالة نفسها. ويوجد مُخطَّط حالة جاهز اسمهMessagesStateيوفّر حقلاً واحداًmessagesمن نوع قائمة كائناتAnyMessageويستخدمadd_messagesتلقائياً.- دالة مخصّصة — أي دالة تقبل
(left, right)وتعيد القيمة المدمجة. هذا مكانك لتفرض قواعد عملك: منع التكرار، الترتيب بالأحدث، سقف أقصى للحجم.
import operator
from typing import Annotated, TypedDict

from langgraph.graph import START, StateGraph


def append_strings(left: list[str], right: list[str]) -> list[str]:
    """دالة دمج: تستقبل القيمة القديمة أولاً ثم الجديدة، وتعيد القيمة المدمجة."""
    return list(dict.fromkeys(left + right))  # يحافظ على الترتيب ولا يكرّر


class State(TypedDict):
    sources: Annotated[list[str], append_strings]  # دمج مع منع التكرار
    log: Annotated[list[str], operator.add]         # دمج مبسّط
    status: str                                     # كتابة فوق


def note_source(state: State) -> State:
    return {
        "sources": ["docs.langchain.com"],
        "log": ["source-recorded"],
        "status": "updated",
    }


builder = StateGraph(State)
builder.add_node("note_source", note_source)
builder.add_edge(START, "note_source")

graph = builder.compile()

print(graph.invoke({"sources": ["previous-note"], "log": ["start"], "status": "new"}))
# {'sources': ['previous-note', 'docs.langchain.com'], 'log': ['start', 'source-recorded'], 'status': 'updated'}
❌ لماذا لا يفرّغ إرجاع قائمة فارغة حقلاً مدموجاً؟ وكيف أفرّغه فعلاً؟
هذا من أكثر فخّ لانغ غراف إزعاجاً، وقد دفع ثمنه كثيرون ساعات من التصحيح بلا أي رسالة خطأ.
السبب بسيط: عندما يحمل الحقل دالة دمج، لا تُستبدل القيمة القديمة — بل تُدمَج القيمة الجديدة فيها. وقائمة فارغة مدمَجة في قائمة غير فارغة تعطي القائمة نفسها. أي أن left + [] == left، والحقل كما هو. والأسوأ أن الكود يبدو صحيحاً تماماً: لا استثناء، لا تحذير، ولا رسالة خطأ.
- حقل بلا دالة دمج → إرجاع
[]يصفّره فعلاً، لأن الافتراضي يكتب فوق. - حقل مدموج → إرجاع
[]لا يغيّر شيئاً؛ تحتاج تجاوز دالة الدمج.
الحل هو Overwrite من langgraph.types: غلّف القيمة بها ليتجاوز الرسم دالة الدمج ويكتب مباشرة في القناة.
import operator
from typing import Annotated, TypedDict

from langgraph.graph import START, StateGraph
from langgraph.types import Overwrite


class State(TypedDict):
    items: Annotated[list[str], operator.add]


def collect(state: State) -> State:
    return {"items": ["kept-item"]}


def clear_items(state: State) -> State:
    # ❌ هكذا لا تفرّغ: إرجاع [] يُدمَج بالقيمة الموجودة فيبقى الحقل كما هو
    # ✅ هكذا تفرّغ: تجاوز دالة الدمج بقيمة جديدة
    return {"items": Overwrite(value=[])}


builder = StateGraph(State)
builder.add_node("collect", collect)
builder.add_node("clear_items", clear_items)
builder.add_edge(START, "collect")
builder.add_edge("collect", "clear_items")

graph = builder.compile()

print(graph.invoke({"items": []}))
# {'items': []}  ← لأن clear_items تجاوزت operator.add
ولحقل الرسائل تحديداً، إضافة إلى Overwrite، توجد قيمة خاصة اسمها REMOVE_ALL_MESSAGES في وحدة langgraph.graph.message تُستخدم مع RemoveMessage لتفريغ سجلّ الرسائل كاملاً بدل إعادة بناء القائمة يدوياً.
ما هي نقطة الحفظ (checkpoint)؟ وماذا يحدث إذا توقّفت العملية في منتصف الطريق؟
نقطة الحفظ هي لقطة للحالة تُكتب تلقائياً أثناء التنفيذ. التحذير المهم هنا أن التوقيت ليس «بعد كل سطر»: عند التجميع مع checkpointer يحفظ لانغ غراف نقاط الحفظ عند حدود الخطوات الكبرى (super-step) لا في منتصف دالة العقدة. وإذا توقّف التنفيذ ثم استُؤنف لاحقاً، فإن العقدة المتأثّرة تُنفَّذ من بدايتها من جديد.
هذه هي الفكرة خلف ما تسمّيه الوثائق «تنفيذ متين (durable execution)»: ليست راية مستقلّة ولا مفتاحاً من نوع durable_execution=True، بل الرسم يكتب نقاط حفظ ويستأنف منها. عملياً يعني ذلك أن أي عمل جانبيّ يسبق نقطة الحفظ قد يتكرّر عند الاستئناف — فاجعله قابلاً للتكرار (idempotent).
لماذا thread_id هو مؤشر المحادثة الدائم؟ وما حدّه الأقصى؟
هذه أهم جملة في الموضوع كله، حرفياً من وثائق الاستمرارية: thread_id الذي تختاره هو مؤشّرك الدائم. إعادة استخدامه تستأنف من آخر نقطة حفظ، واستخدام قيمة جديدة يبدأ محادثة جديدة تماماً بحالة فارغة.
عملياً هذا يعني ثلاثة أشياء يخطئ فيها كثيرون:
thread_idيخصّ المحادثة لا المستخدم. لا تجعلهuser_id. مستخدم واحد يفتح عشر محادثات يحتاج عشر قيم مختلفة؛ ومشاركة المعرفة بين محادثاته هي عملstoreلا عملthread_id.- يجب أن تكون القيمة ثابتة ومستمَردّة. لا تولّدها عشوائياً في كل طلب، ولا تشتقّها من ساعة النظام.
- يجب أن تكون قصيرة.
⚠️ حدّ إنتاجي حقيقي: أبقِ
thread_idدون 255 حرفاً. الوثائق تذكره ضمن إصلاحات الإنتاج بصيغة صريحة: «أبقِ قيمthread_idدون 255 حرفاً». السبب أن القيمة تُخزَّن في عمود بطول محدود عند استخدامPostgresSaver. وهذا الخطأ لا يظهر في التطوير ولا في الاختبار — بل عند أول مستخدم حقيقي يحمل معرّفاً طويلاً.
from langchain.agents import create_agent
from langgraph.checkpoint.memory import InMemorySaver

# نفس معرّف النموذج بصيغة "provider:model" الذي ضبطته في مقال الواجهة الموحّدة للنماذج
MODEL = "your-provider:your-model"

agent = create_agent(
    model=MODEL,
    tools=[],
    checkpointer=InMemorySaver(),  # ⚠️ في الذاكرة العشوائية فقط — للتعلّم
)

config = {"configurable": {"thread_id": "thread-sara"}}

agent.invoke(
    {"messages": [{"role": "user", "content": "اسمي سارة وأعمل في الهندسة."}]},
    config,
)
agent.invoke(
    {"messages": [{"role": "user", "content": "ما اسمي وما مهنتي؟"}]},
    config,
)
الاستدعاء الثاني لا يبدأ من فراغ: يجد الحالة المحفوظة تحت thread-sara ويضيف عليها. جرّب الآن أن تغيّر القيمة إلى thread-sara-followup وأعد الاستدعاء الثاني — ستبدأ من جديد. ولاحظ أن thread_id يُمرَّر داخل config["configurable"] وليس كوسيط مستقل؛ هذا التفصيل الصغير مصدر أخطاء كثيرة عند أول استخدام.
ما الفرق بين الذاكرة قصيرة المدى والذاكرة طويلة المدى؟
التعريف الرسمي واضح ومباشر: الذاكرة قصيرة المدى، أو ذاكرة محصورة بحدود المحادثة، تتابع المحادثة الجارية بتحتفظ بسجلّ الرسائل داخل الجلسة. أما الذاكرة طويلة المدى فتخزّن بيانات تخصّ المستخدم أو التطبيق عبر الجلسات، وهي مشتركة بين المحادثات.
| الذاكرة قصيرة المدى | الذاكرة طويلة المدى | |
|---|---|---|
| منطقها | مُحافِظ نقاط (checkpointer) | مخزن (store) |
| نطاقها | محادثة واحدة | كل محادثات المستخدم |
| ماذا تحفظ | سجلّ الرسائل والحالة التشغيلية | تفضيلات، حقائق، تعليمات، خبرات سابقة |
| مفتاح الوصول | thread_id |
نطاق مُسمّى (namespace) + مفتاح (key) |
ولماذا تهمّك الذاكرة قصيرة المدى أصلاً؟ لأن المشكلة التي تحلّها حقيقية: السجلّ الكامل قد لا يتّسع داخل نافذة السياق (context window) للنموذج اللغوي، فينتهي الأمر بخطأ لا يمكن التعافي منه. وحتى لو قبل نموذجك السياق الطويل، فإن أداء معظم النماذج اللغوية يتدهور على السياقات الطويلة. عملياً: احفظ النقاط دائماً، لكن لا ترسل كل شيء إلى النموذج.
كيف أكتب ذاكرة طويلة المدى في store بالنطاق المُسمّى والمفتاح؟
المخزن لا يخزّن الحالة، بل وثائق JSON يحدّدها تطبيقك. وكل ذاكرة تُنظَّم تحت نطاق مُسمّى (namespace) شبيه بالمجلّد، ومفتاح فريد (key) شبيه باسم الملف. هذا هو التمييز الذي يحلّ مشكلة «المعرفة المشتركة بين المستخدمين» من غير أن تخلطها بحالة الرسم.
from langgraph.store.memory import InMemoryStore

store = InMemoryStore()

# النطاق المُسمّى = مجلد، والمفتاح = اسم ملف داخله
namespace = ("sara", "preferences")

store.put(namespace, "language", {"value": "ar"})
store.put(namespace, "tone", {"value": "formal"})
store.put(namespace, "language", {"value": "ar"})  # تحديث نفس المفتاح، لا تكرار

for item in store.search(namespace):
    print(item.key, item.value)

print(store.get(namespace, "tone"))
ولقراءة الذاكرة من داخل عقدة، تمرّرها عبر runtime.store بدل تمرير الكائن يدوياً إلى كل عقدة. هذا مثال رسمي قابل للتشغيل:
from dataclasses import dataclass
from typing import TypedDict

from langgraph.graph import StateGraph
from langgraph.runtime import Runtime
from langgraph.store.memory import InMemoryStore


@dataclass
class Context:
    user_id: str


class State(TypedDict, total=False):
    response: str


store = InMemoryStore()
store.put(("users",), "user_sara", {"name": "Alice"})


def personalized_greeting(state: State, runtime: Runtime[Context]) -> State:
    user_id = runtime.context.user_id
    name = "unknown_user"
    if runtime.store:
        if memory := runtime.store.get(("users",), user_id):
            name = memory.value["name"]

    return {"response": f"Hello {name}! Nice to see you again."}


graph = (
    StateGraph(state_schema=State, context_schema=Context)
    .add_node("personalized_greeting", personalized_greeting)
    .set_entry_point("personalized_greeting")
    .set_finish_point("personalized_greeting")
    .compile(store=store)
)

print(graph.invoke({}, context=Context(user_id="user_sara")))
# {'response': 'Hello Alice! Nice to see you again.'}
انتبه للفرق بين النطاقين: نطاق التطبيق هنا ("users",) ومفتاحه user_sara، بينما النطاق الذي يربط الذاكرة بمستخدم في تطبيق متعدّد المستأجرين يشبه ("sara", "preferences"). اجعل مستوى النطاق الأول دائماً معرّف المستخدم، وإلا اختلطت الذاكرة بين المستأجرين.
ما الأنواع الثلاثة للذاكرة؟ الدلالية والتجريبية والإجرائية
الوثائق تصنّف الذاكرة في ثلاثة أنواع، وهذا الجدول هو المرجع الذي يجب أن تعتمد عليه عند تصميم نظام ذاكرة:
| النوع | ماذا يحفظ | مثال في الوثائق | مثال تطبيقي في وكيلك |
|---|---|---|---|
| ذاكرة دلالية (semantic) | الحقائق | ما تعلّمته في المدرسة؛ حقائق عن مستخدم | «يفضّل الردّ بالعربية»، «اشتراكه في المستوى المتقدّم» |
| ذاكرة تجريبية (episodic) | الخبرات | ما فعلته؛ إجراءات الوكيل السابقة | «آخر مرة فشل البحث، فاعتمدنا على المصدر البديل» |
| ذاكرة إجرائية (procedural) | التعليمات والقواعد | الغرائز أو المهارات الحركية | الموجّه النظامي للوكيل، وقواعد تنسيق المخرجات |
الفائدة العملية من الجدول ليست نظرية: عند مراجعة أي سطر يكتبه وكيلك في store، اسأل «هل هذا واقعة، أم عن دراية؟» الأولى مكانها الذاكرة الدلالية، والثانية مكانها الذاكرة التجريبية، وإن كان قاعدة يطبّقها دائماً فمكانها الذاكرة الإجرائية. الخلط بين الثلاثة يجعل الذاكرة غير قابلة للمراجعة ولا للنمو.
هل الذاكرة الدلالية هي البحث الدلالي (semantic search)؟ لا، والفرق جوهري
هذا الخلط من أكثر ما يقابلنا، لأن الكلمتين تشبهان اسم علم واحد — والوثائق تنصّ على أنهما مختلفتان: الذاكرة الدلالية شيء مختلف عن «البحث الدلالي»، وهي تقنية لإيجاد محتوى مشابه بالمعنى (عادةً عبر التضمينات).
بعبارة عملية:
- الذاكرة الدلالية = ماذا خزّنت. معلومة محفوظة في
storeتحت نطاق ومفتاح. لا علاقة لها بتقنية الاسترجاع؛ يمكنك قراءة ذاكرة دلالية بجلب مباشر بـstore.get(...)بلا أي تضمينات ولا فهرس متجهات. - البحث الدلالي = كيف تجد شيئاً مشابهاً. تقنية استرجاع تقارن المعنى، وغالباً ما تكون فوق مخزن متجهات.
كلاهما يجلس في الغالب في نفس التطبيق وفي نفس المخزن — لكن هما سؤالان مختلفان تماماً، وخلطهما يقود إلى بنية لا يفهمها من يقرأها بعدك.
⚠️ هل القنوات الخاصة في الحالة آمنة أثناء البثّ؟ لا، وهي تُكشف
هذا أهم تنبيه أمني في المقال، وهو من النوع الذي يُكلّف شهادات اختراق لا أخطاء تشغيل. الوثائق تحذّر بعبارة حاسمة: القنوات الخاصة لا تُحجب عند البثّ. مُخطّطات الإدخال والإخراج والقنوات الخاصة تقيّد ما تقرأه كل عقدة، لكنها لا تخفي القنوات عن stream.
الترجمة الحقيقية لهذه العبارة: إذا وضعت مفتاحاً داخلياً أو بيانات تعريف شخصية في حقل من حقول الحالة، ثم بثّيت رسمك إلى واجهة ويب، فسيصل ذلك الحقل في تدفّق الأحداث. «خاص» هنا تعني خاصاً بالقراءة داخل الرسم، لا مخفياً عن العميل.
ماذا تفعل بدل ذلك:
- حدّد ما تعلن إرساله صراحةً عبر
stream_mode="updates"أوoutput_keys=[...]عندstream_events، ثم رشّح عند الإرسال. - لا تضع أسراراً أو بيانات تعريف شخصية في الحالة إطلاقاً. الحالة سجلّ تدفّق، وليست خزنة.
- عامل أي بثّ كأن كل حقل في الحالة سيُعرض على الطرف الآخر، حتى لو كان اسم الحقل يقول العكس.
ماذا سأبني عملياً في هذا المقال؟
اجمع القطع الثلاث في وكيل واحد يتذكّر داخل المحادثة ويكتب ذاكرة عابرة لها:
- اختر
checkpointerقبل أن تكتب أول سطر.InMemorySaverللتعلّم فقط؛ استخدم بديلاً يكتب على القرص أو في قاعدة بيانات لأي شيء يخرج من جهازك. - اضبط
thread_idبعناية. ثابت، قصير، دون 255 حرفاً، خاص بالمحادثة لا بالمستخدم. اجعل توليده دالة واحدة صغيرة في مشروعك حتى لا يختلف بين الطلبات. - ضع
storeخلف معرّف المستخدم. النطاق الأول هو المستخدم، والنطاق الثاني هو نوع البيانات (preferencesأوhistory)، والمفتاح هو معرّف العنصر. - اكتب لكل حقل قراراً صريحاً: يُدمج أم يُكتب فوقه؟ وأي دالة دمج؟ وهل تحتاج يوماً إلى
Overwriteلتفريغه؟ - راجع أسماء حقول الحالة كأنها واجهة عامة. كل ما ستضعه فيها قد يُكشف أثناء البثّ.
الأسئلة التي يجب أن تستطيع الإجابة عنها بعد بناء وكيلك:
- ما الذي يجعل الوكيل يستأنف محادثة قديمة؟ وما الذي يجعله يبدأ واحدة جديدة؟
- أين بالضبط تُحفظ حالتي، وماذا يحدث لها عند إعادة التشغيل؟
- ما الفرق بين حقل مدموج وحقل يُكتب فوقه في مخططك؟
- أيّ من أنواع الذاكرة الثلاثة يمثّله كل سطر كتبته في
store؟ - هل يوجد في حالتي أي حقل لا أريد أن يصل إلى الواجهة؟
تحتاج وكيلاً يعمل لفريقك؟
نصمّم ونبني أنظمة وكلاء للشركات والأفراد فوق لانغ تشين (LangChain) ولانغ غراف (LangGraph) — من إثبات المفهوم في أسبوع إلى نظام إنتاجي يُشغَّل يومياً. ابدأ بطلبك من صفحة التواصل.
المصادر
كل ادعاء في المقال مرتبط بمصدره. الروابط تفتح في نافذة جديدة.
- 01LangGraph — Graph API (state, reducers, nodes) ↗
docs.langchain.com
الدالة الافتراضية للدمج تتجاهل الطرف الأيسر وتستبدل قيمة الحالة بالطرف الأيمن.
- 02LangChain — Memory (concepts) ↗
docs.langchain.com
الذاكرة الدلالية شيء مختلف عن البحث الدلالي، تقنية لإيجاد محتوى مشابه بالمعنى عادةً عبر التضمينات.
- 03LangGraph — Graph API (state, reducers, nodes) ↗
docs.langchain.com
القنوات الخاصة في الحالة لا تُحجب عند البثّ: مُخطّطات الإدخال والإخراج والخاصة تقيّد ما تقرأه العقد ولا تخفي القنوات عن `stream`.
- 04LangGraph — Persistence ↗
docs.langchain.com
طبقة الاستمرارية في لانغ غراف تمنح الوكلاء ذاكرة قصيرة المدى عبر مُحافِظات النقاط (checkpointers) وذاكرة طويلة المدى عبر المخازن (stores).
- 05LangGraph — Persistence ↗
docs.langchain.com
يجب إبقاء قيم `thread_id` دون 255 حرفاً، وهو إصلاح ورد في وثائق الاستمرارية ضمن مشاكل الإنتاج.
- 06LangGraph — Persistence ↗
docs.langchain.com
`MemorySaver` و`InMemorySaver` يخزّنان نقاط الحفظ في الذاكرة العشوائية (RAM)، وكل النقاط تضيع عند إعادة تشغيل العملية.
- 07LangGraph — Graph API (state, reducers, nodes) ↗
docs.langchain.com
`create_agent` الأعلى مستوى في لانغ تشين لا يدعم مُخطَّطات حالة من نوع Pydantic.
- 08LangGraph — Persistence ↗
docs.langchain.com
`thread_id` الذي تختاره هو مؤشّرك الدائم: إعادة استخدامه تستأنف نفس نقطة الحفظ، والقيمة الجديدة تبدأ محادثة جديدة بحالة فارغة.