منطق المسار ومعالجة الأخطاء في n8n: `If` و`Switch` و`Retry On Fail` — والفخّ الذي يوقف كل شيء
سير العمل لا ينهار بسبب تعقيده، بل لأن فشل عقدة واحدة يوقف كل ما بعدها. نشرح أوضاع معالجة الخطأ الثلاثة، ونقول بصراحة أين تنتهي حدود إعادة المحاولة المدمجة ولماذا يجب ألّا تخطّط لسقفها قبل أن يوثّقه n8n رسمياً.
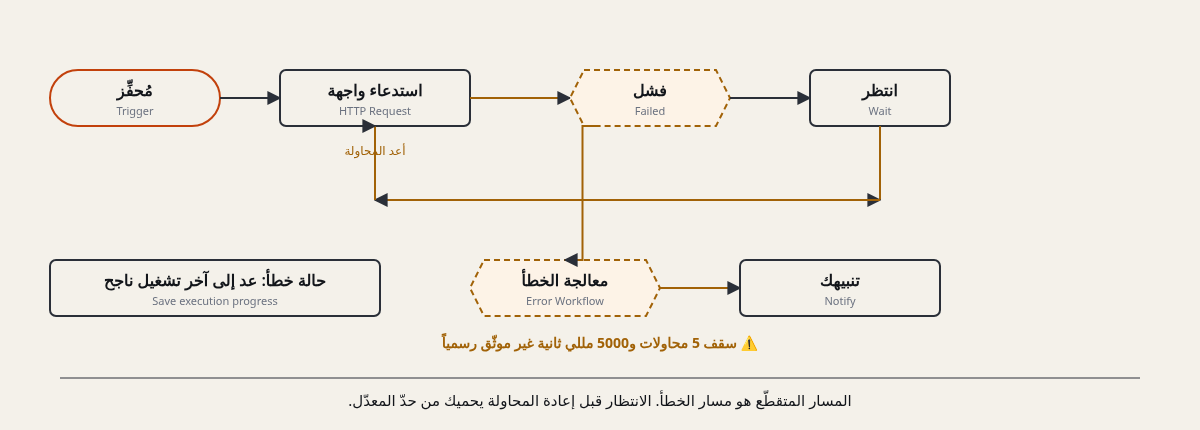
المشكلة ليست أن سير العمل فشل. المشكلة أن فشلَ عقدة واحدة أوقف كل ما بعدها — بينما كانت البيانات قد وصلت سليمة، والخطوة التالية كانت جاهزة. الفارق بين الحالتين كان خدمة خارجية رفضت الطلب في تلك الثانية.
وهذا هو الفارق الحقيقي بين «يعمل على جهازي» و«يعمل في الإنتاج»: على جهازك تفشل الخدمات الخارجية نادراً، فتبدو كل الإعدادات سليمة. في الإنتاج تفشل دورياً، وتنتهي مهلة الجلسة، ويصبح خطأ واحد في عقدة واحدة نهايةً لما بعدها كله.
في هذا المقال ثلاثة إعدادات فقط على الطاولة: ماذا يفعل n8n حين تفشل عقدة، وكيف يُعيد المحاولة، وأين تنتهي حدود إعادة المحاولة — بما فيها حدّان لا يوثّقهما n8n رسمياً.
أسماء الخيارات في كل ما يلي باللاتينية عمداً، لأنها كما تراها حرفياً داخل n8n. وكل ⚠️ يعني خطأً يجب أن تعرفه قبل أن تبني، لا بعد أن تبني.
ماذا يحدث لبقية المسار حين تفشل عقدة؟ ثلاثة أوضاع لا رابع لها
لدى n8n ثلاثة أوضاع في On Error، وكل واحد منها قرار مختلف لا يمكن ترجمته:
| الوضع | ما يقوله n8n حرفياً | متى يكون قراراً صحيحاً |
|---|---|---|
Stop Workflow |
«Halts the entire workflow when an error occurs, preventing further node execution.» | حين يكون صمت بقية المسار هو السلوك الصحيح: فاتورة بلا إشعار أسوأ من إشعار خطأ. |
Continue |
«Proceeds to the next node despite the error, using the last valid data.» | حين تتعامل مع عقدة جانبية لا أهمية لها، ولا يهمّك إن كان ما بعدها قديم. |
Continue (using error output) |
«Continues workflow execution, passing error information to the next node for potential handling.» | حين تريد أن تُصلح الخطأ بنفسك، أو تنتظر ثم تُعيد — وهذا هو الوضع الوحيد الذي يفتح لك مخرجاً جديداً على اللوحة. |
الفرق بين الثاني والثالث ليس فرقاً في التسمية. Continue يرمي الخطأ ويكمل بآخر بيانات صالحة، أي أن العقدة التالية ستعالج بيانات قديمة دون أن تعرف. في عمل يتناول فوترة أو مدفوعات أو حالة عميل، هذا أسوأ من التوقف: صمتٌ بلا خطأ.
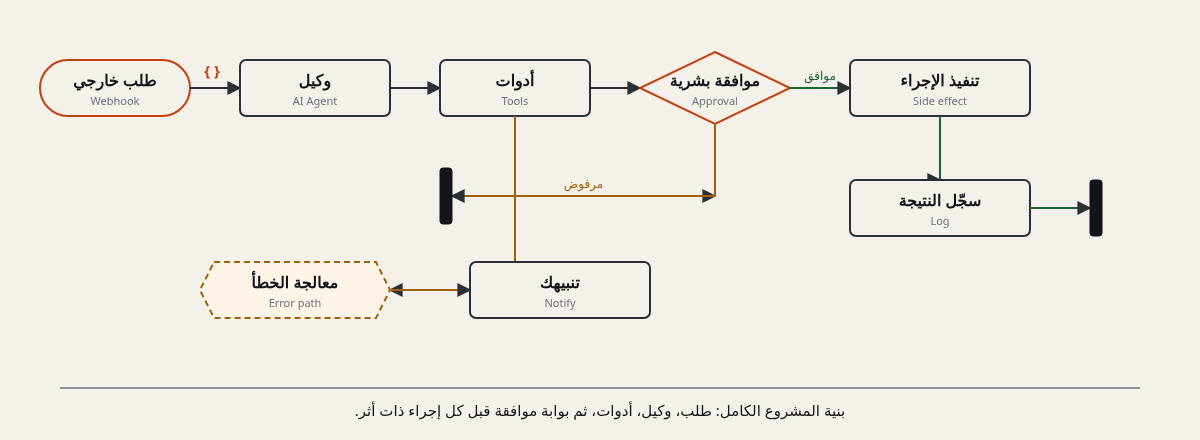
أما Continue (using error output) فيمرّر معلومات الخطأ إلى العقدة التالية، فيظهر على اللوحة مخرج ثانٍ — مخرج الخطأ — توصّله إلى عقدة تعالجه أو تنتظر ثم تُعيد.
⚠️ أكبر فخّ في الموضوع: سقف إعادة المحاولة المدمج غير موثّق رسمياً
⚠️ قبل أن تبدأ الرقمان الوحيدان اللذان نستطيع ذكرهما عن سقف
Retry On Fail— وهما رقمان قرأهما المستخدمون من المجتمع وبلاغات GitHub، لا من التوثيق — هما5محاولات و5000مللي ثانية. لا تبنِ خطّة تشغيل إنتاجية على غيرهما، ولا تنقلهما في عرض تقديمي كأنهما موثّقان. ما لم يوثّقه n8n يمكن أن يتغيّر من إصدار إلى إصدار بلا إشعار.
الخطأ يصيب كل من يعتمد على Retry On Fail هكذا: تكتب رقماً كبيراً في Max Tries، فيقفز الحقل إلى قيمة أخرى. هذا ما يصفه بلاغ في مستودع n8n على GitHub:
«it seems like the fields Max. Tries has a limit of 5 and the Wait Between tries has a Max of 5000 ms.»
البلاغ نفسه مذكور في قائمة المصادر أسفل المقال. ولاحظ مصدر المعلومة: ليس من docs.n8n.io. لم نعثر في التوثيق الرسمي على سطر واحد يذكر هذا السقف.
ويفسّره نقاش مجتمع n8n بأنه حدّ عمداً، كي لا تجمّد إعادة المحاولة الطويلة خيوط العامل، وأن ما يحتاج انتظاراً أطول من 5 ثوانٍ لا بدّ من بنائه بنفسك بعقدة انتظار.
الأثر العملي: 5000 مللي ثانية تعني خمس ثوانٍ بين المحاولة والتي بعدها. إن كانت خدمتك الخارجية لا تنجح إلا بعد دقائق من الانتظار، فخمس ثوانٍ لا تُعيد شيئاً — وستنتهي بانتهاء مهلة التنفيذ، لا بنجاح.
الحل الموثّق: عقدة Wait تعيد التوصيل إلى العقدة الفاشلة
البديل الذي يصفه n8n نفسه: لا تعِد ضبط سقف Max Tries، بل اصنع الحلقة بعقدة Wait.
- افتح تبويب
Settingsفي العقدة الفاشلة، وحوّلOn ErrorإلىContinue (using error output). - أوصل مخرج الخطأ إلى عقدة
Wait، واضبط المدة التي تحتاجها الخدمة فعلاً. - أوصل مخرج
Waitإلى مدخل العقدة الفاشلة نفسها — لا إلى مخرجها.
هذا يحوّل عقدة واحدة إلى حلقة تستطيع الانتظار ما تشاء، لأنها لم تعد محكومة بالحقلين اللذين لهما سقف.
ثمن هذه الحلقة، واذكره صراحةً قبل أن تتبنّاها: لا شيء فيها يوقفها. لم تعد n8n هي من يقرّر متى تتوقف، فصار قرار التوقف لك. ضع حدّاً للمحاولات داخل سير العمل، وسجّل عدّاداً، وإلا فقد بنيت حلقة لا نهائية في الإنتاج عن غير قصد.
ولتقرأ تفاصيل الخطأ من مخرج الخطأ — لرسالة إلى Slack مثلاً، أو لتخزينها — تحتاج تعبيراً يصل إلى القيمة داخل بيانات الخطأ؛ طريقة قراءة قيمة من عقدة سابقة مشروحة في التعبيرات في n8n.
⚠️ خلل مفتوح: Retry On Fail مع Continue يُلغي إعدادك
هناك بلاغ ثانٍ في GitHub، مفتوح ولم يُحلّ وقت كتابة هذا المقال، يصف تعارضاً مباشراً بين الإعدادين:
«If Retry on Fail is switched on AND On Error is set to one of the Continue options, Max. Tries and Wait Between Tries (ms) settings are ignored.»
الخلل هو: بمجرّد أن تختار أحد وضعي Continue، تتوقف Retry On Fail عن قراءة Max Tries وWait Between Tries (ms) — وإعداداتك تبقى سليمة في الواجهة، والسلوك لا يطابقها.
وهذا يناقض ما يقوله n8n عن الإعداد نفسه:
«When an execution fails, the node reruns until it succeeds.»
القاعدة العملية التي نخرج بها: لا تجمع بين «إعادة المحاولة» و«متابعة» أبداً. إمّا تعتمد على Retry On Fail وتقبل سقفه غير الموثّق، وتترك On Error على Stop Workflow. أو تترك Retry On Fail مطفأً وتبني الحلقة بعقدة Wait. أما جمعهما معاً فهو بالضبط المنطقة التي يبقى فيها السلوك غير مضمون.
الخطأ 429: حين يقول الخادم إنك تطلب أكثر من اللازم
هذا الخطأ له رسالة ثابتة في n8n، احفظها حرفياً:
«If n8n received error 429 (too many requests) from the service, the error message is The service is receiving too many requests from you.»
ولدى n8n وصفة واضحة لـRetry On Fail في هذه الحالة تحديداً:
«4. Configure the retry settings: if using this to work around rate limits, set Wait Between Tries (ms) to more than the rate limit. For example, if the API you're using allows one request per second, set Wait Between Tries (ms) to
1000to allow a 1 second wait.»
عملياً: الواجهة البرمجية التي تسمح بطلب في الثانية تحتاج 1000 مللي ثانية بين المحاولات، وأي رقم أقل من ذلك يجرّ عليك 429 جديداً بعد كل محاولة.
وهنا تحفّظ صادق: قيمة 1000 آمنة لأنها تقع تحت السقف غير الموثّق الذي ذكرناه. أما ما تكتبه فوقه فهو رقم في حقل قد يقفز.
ومن مخطّط n8n نفسه ثلاث خطوات لتقليل الضغط بدل الاعتماد على الانتظار وحده:
- في عقدة
HTTP Request، اخترAdd Option > Batching. - اضبط
Items per Batch: عدد عناصر الإدخال التي تُدرَج في كل طلب. - اضبط
Batch Interval (ms)لإدخال تأخير بين الطلبات.
سير عمل الأخطاء: طبقة لا تظهر على اللوحة
لكل سير عمل، في Workflow Settings، يمكن تحديد سير عمل للأخطاء، ويعمل حين يفشل التنفيذ:
«For each workflow, you can set an error workflow in Workflow Settings. It runs if an execution fails.»
شرطان لا ثالث لهما: أن يبدأ بعقدة Error Trigger، وأن يمكن إعادة استعماله لعدة سيرَيات عمل:
«The error workflow must start with the [Error Trigger] … You can use the same error workflow for multiple workflows.»
وهذا ما يصل إلى معالج أخطاءك حين تفشل عقدة داخل المسار:
[
	{
		"execution": {
			"id": "231",
			"url": "https://n8n.example.com/execution/231",
			"retryOf": "34",
			"error": { "message": "Example Error Message", "stack": "Stacktrace" },
			"lastNodeExecuted": "Node With Error",
			"mode": "manual"
		},
		"workflow": { "id": "1", "name": "Example Workflow" }
	}
]
⚠️ لكن حين يفشل المُحفِّز نفسه، لا يصل الخطأ في هذا الشكل. يأتي ملف مختلف تماماً، الخطأ فيه تحت مفتاح trigger مع اسم WorkflowActivationError:
{
  "trigger": {
    "error": {
      "context": {}, "name": "WorkflowActivationError",
      "cause": { "message": "", "stack": "" },
      "timestamp": 1654609328787, "message": "",
      "node": null
    },
    "mode": "trigger"
  },
  "workflow": { "id": "", "name": "" }
}
النتيجة العملية: معالج الخطأ الذي يقرأ رسالة الخطأ من مكانه المعتاد سيصمت تماماً عند فشل المُحفِّز، وستظنّ أن نظام الإنذار سليم لأنه لا يستقبل شيئاً أصلاً. اقرأ الحالتين في معالجك، لا واحدة فقط.
ولتختبر مسار الخطأ عمداً، لا بانتظار أن تفشل خدمة خارجية في يومٍ لا يأتي:
«You can add the [Stop And Error] node to your workflow to force executions to fail under your chosen circumstances, and trigger the error workflow.»
🎉 ميزة لا يعرفها أحد: تنفيذات سير عمل الأخطاء لم تعد تُحتسب
هذه أوضح فائدة عملية في المقال كله، صدرت في سجلّ تغييرات n8n بعنوان صريح: «Error workflow executions no longer count towards your quota» — أي أن تشغيلات سير عمل الأخطاء صارت خارج حصّتك، على كل الخطط.
والتفاصيل مهمّة للاختيار بين Cloud والاستضافة الذاتية:
«Runs of your error workflows are now excluded from your execution quota, on every plan.»
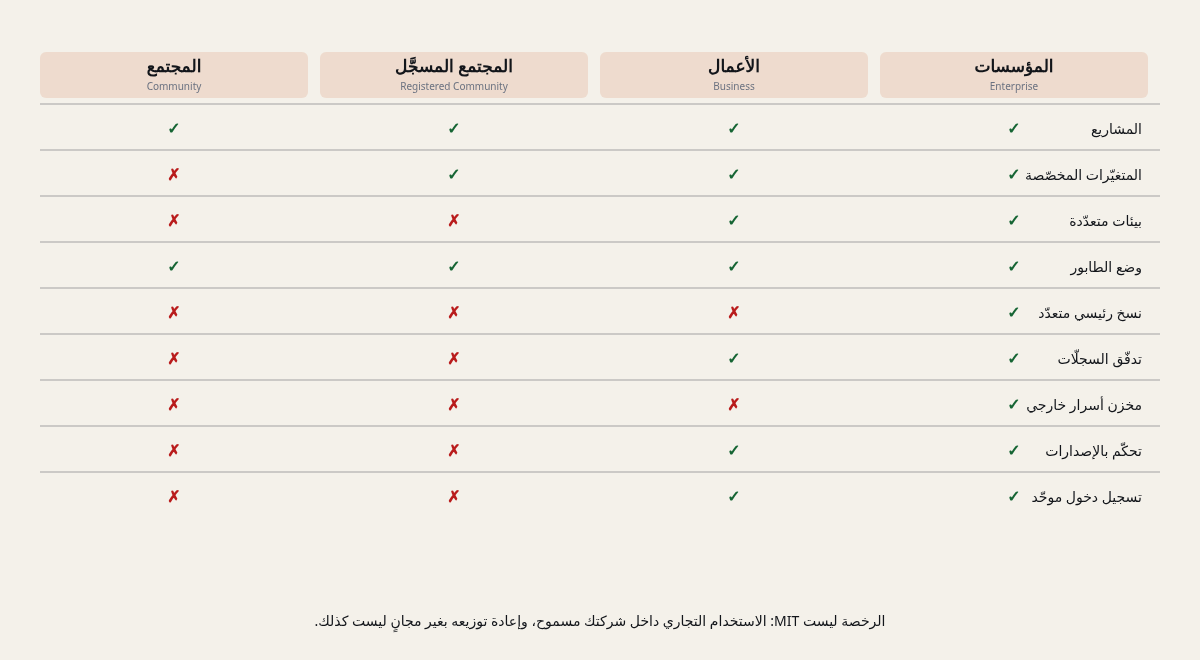
«The change applies on Cloud from 2.38, and on self-hosted Business and Enterprise instances from 2.28.0, or 1.123.60 if you're still on v1.»
التاريخ الرسمي للصدور: 2026-09-01 في n8n 2.38.
لماذا يغيّر هذا قراراً معمارياً؟ قبل ذلك، كان الطريق إلى التنبيه على الأعطال محسوباً من حصّتك: من يريد طبقة إنذار دائمة كان يدفع ثمنها. الآن مسار الإنذار لا يُحتسب — على Cloud منذ 2.38، وعلى الاستضافة الذاتية Business وEnterprise منذ 2.28.0، أو 1.123.60 لمن لا يزال على خطّ v1.
⚠️ وهنا تحقّق من نسختك أنت قبل أن تبنِ قراراً: النص يذكر الاستضافة الذاتية Business وEnterprise تحديداً، فنصّ n8n لا يوسّع الاستثناء إلى ما عداه، وإهمال هذه النقطة يعني بقاء إنذاراتك محسوبة من حصّتك.
⚠️ ترتيب التنفيذ v1 مقابل v0: تغييرٌ صامت
في إعدادات سير العمل مفتاح Execution Order له نسختان، والفرق بينهما جوهري:
«v1 (recommended) executes each branch in turn, completing one branch before starting another.»
«v0 (legacy) executes the first node of each branch, then the second node of each branch, and so on.»
بعبارة أخرى: v1 يُنهي فرعاً كاملاً ثم يبدأ الذي يليه. أما v0 فيوزّع التنفيذ بالتناوب: أول عقدة في كل فرع، ثم ثاني عقدة في كل فرع، وهكذا.
لماذا يهمّ هذا في سياق الأخطاء؟ لأن الفشل في فرع لا يلغي فرعاً آخر نصف منفَّذ. في v0 قد يكون الفرع المجاور قد نفّذ أول عقدتين من ثلاث حين يتوقف كل شيء، فتدخل سير عمل الأخطاء وتجد تنفيذاً نصف مكتمل، وتبني تشخيصك على صورة خاطئة. في v1 إما أن يُنهي الفرع أو لم يبدأ أصلاً.
القاعدة: اتركها على v1 الموصى به، وتحقّق منها صراحةً عند الاستيراد من قالب أو من سير عمل قديم، لأن الفارق هنا لا يرفع تحذيراً.
⚠️ Always Output Data: نعمة على عقد البيانات، وباب حلقة لا نهائية
هذا الإعداد معرّف في التوثيق بجملة واحدة: «The node returns an empty item even if the node returns no data during execution. Be careful setting this on IF nodes, as it could cause an infinite loop.» — أي أن العقدة تُرجع عنصراً فارغاً حتى حين لا تملك بيانات، والتحذير بعدها مباشر.
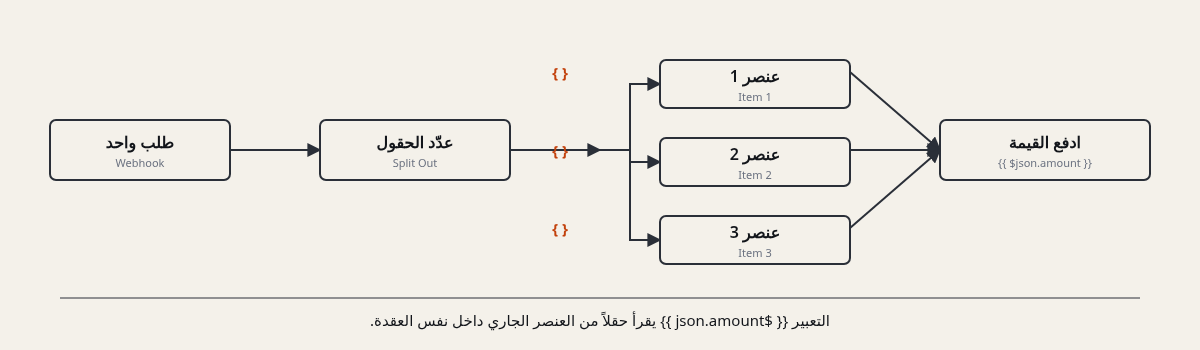
وللتحذير سبب تقني: عقدة If توزّع البيانات، ويمرّ التفرّع عنصراً عنصراً. عنصر فارغ في مخرج If يعني فرعاً يُنفَّذ وهو فارغ، وإن كان ذلك الفرع يعود إلى مدخل نفسه — فأنت تبني دورة مغلقة لا تتوقف.
ولهذا السبب تحديداً، لا تُفعّل Always Output Data على عقدة If داخل حلقة إعادة المحاولة التي بنيناها قبل قليل.
والتوثيق يصف تغيّراً في هذا السلوك نفسه: «With Always Output Data on, nodes with several outputs, for example If and Switch, now add an empty item only when every output is empty.» — أي أن الفروع الفارغة لم تعد تمرّر عنصراً فارغاً تلقائياً. إن كان سير عملك يعتمد على السلوك القديم، فالنتيجة أن فرعاً كان يُنفَّذ خطأ لن يُنفَّذ بعد اليوم، والفرق بينهما ليس خطأً في n8n بل تغيّر صامت في السلوك.
قائمة تحقّق قبل النشر
- لكل عقدة تتصل بخدمة خارجية: قرار
On Errorمكتوب ومقصود، لا موروث من إعدادات افتراضية. - لا تُفعّل
Retry On Failمع أيٍّ من وضعيContinueمعاً — الخلل مفتوح. - انتظارك أطول من
5ثوانٍ؟ ابنِ حلقةWait، ولا تعتمد علىMax Tries. - في حلقة
Waitالتي بنيتها: حدّ للمحاولات تحطّه أنت، وسجلّ يعدّ المحاولات. - خطأ
429في سجلّك؟ راجعWait Between Tries (ms)وقيمة1000، وفعّلBatching. - سير عمل أخطاء واحد يبدأ بـ
Error Trigger، وقد اختبرت الحالتين: فشل عقدة داخل المسار، وفشل المُحفِّز نفسه — البيانات تصل في شكلين مختلفين. - تحقّقت أن نسختك من الاستضافة الذاتية تشمل استثناء حصّة تنفيذات الأخطاء.
- اختبرت مسار خطأ حقيقي بـ
Stop And Error، لا بمجرد فصل اتصالك بالإنترنت. -
Execution Orderعلىv1، وAlways Output Dataمطفأ على كل عقدةIf.
وإن كنت ما زلت في أول الطريق مع n8n، فابدأ من دليل السلسلة. وعمود السلسلة — وهو الواجب أن ترجع إليه بدل إعادة الشرح — هو الوكلاء الثلاثة في n8n، لأن كل ما قرأته هنا ينطبق على وكيل يعمل داخل سير عمل بالذات.
أُراجع في n8n 2.42.5 (2026-10-08). n8n يُصدر نسخاً جديدة أسبوعياً تقريباً، فراجع التوثيق إن كان عمرك يتجاوز بضعة أشهر.
تحتاج أتمتة تعمل فعلاً؟
نصمّم ونبني أنظمة أتمتة للشركات والأفراد على n8n — من أول سير عمل يعمل خلال يوم، إلى وكيل يوثّق خطواته ويطلب موافقة بشرية قبل أي إجراء حسّاس. اكتب لنا وضعك من صفحة التواصل.
المصادر
كل ادعاء في المقال مرتبط بمصدره. الروابط تفتح في نافذة جديدة.
- 01Node settings: Retry On Fail, On Error, Always Output Data (n8n docs) ↗
docs.n8n.io
Always Output Data تُرجع عنصراً فارغاً حتى حين لا تُرجع العقدة بيانات، ويحذّر التوثيق من استخدامها على IF nodes لأنها قد تسبب حلقة لا نهائية.
- 02Node settings: Retry On Fail, On Error, Always Output Data (n8n docs) ↗
docs.n8n.io
Retry On Fail تعيد تشغيل العقدة حتى تنجح: When an execution fails, the node reruns until it succeeds.
- 03Node settings: Retry On Fail, On Error, Always Output Data (n8n docs) ↗
docs.n8n.io
أوضاع On Error في إعدادات العقدة ثلاثة لا رابع لها: Stop Workflow وContinue وContinue (using error output).
- 04Handle rate limits: Retry On Fail, the 429 error message, HTTP Request batching (n8n docs) ↗
docs.n8n.io
إذا كانت واجهة برمجية تسمح بطلب واحد في الثانية، ينصح n8n بضبط Wait Between Tries (ms) على 1000.
- 05GitHub issue #16083 — Max. Tries limit of 5 and Wait Between tries max of 5000 ms (community report) ↗
github.com
بحسب بلاغ مجتمعي، يبدو أن الحقل Max. Tries محدود بـ 5 وأن الحقل Wait Between tries أقصاه 5000 مللي ثانية، وهو حدّ غير مذكور في التوثيق الرسمي.
- 06Configure workflow settings — n8n docs ↗
docs.n8n.io
ترتيب التنفيذ v1 الموصى به ينفّذ كل فرع بالترتيب مُنهياً فرعاً قبل بدء آخر، بينما v0 (legacy) ينفّذ أول عقدة في كل فرع ثم ثاني عقدة في كل فرع وهكذا.
- 07n8n Docs — Changelog (وتيرة الإصدارات) ↗
docs.n8n.io
تنفيذات سير عمل الأخطاء لم تعد تُحتسب في الحصّة؛ صدر ذلك بتاريخ 2026-09-01 في n8n 2.38، وعلى نسخ الاستضافة الذاتية Business وEnterprise يسري من 2.28.0 أو من 1.123.60 لمن لا يزال على v1.
- 08Handle rate limits: Retry On Fail, the 429 error message, HTTP Request batching (n8n docs) ↗
docs.n8n.io
عندما يتلقى n8n الخطأ 429 من الخدمة، تكون رسالة الخطأ: The service is receiving too many requests from you.
- 09Configure workflow settings — n8n docs ↗
docs.n8n.io
مع تفعيل Always Output Data، تضيف العقدات ذات المخرجات المتعددة مثل If وSwitch عنصراً فارغاً فقط حين تكون كل المخرجات فارغة.
- 10Handle errors gracefully — error workflows and the Error Trigger ↗
docs.n8n.io
يجب أن يبدأ سير عمل الأخطاء بعقدة Error Trigger، ويمكن استخدام سير عمل الأخطاء نفسه لعدة سيرَيات عمل.